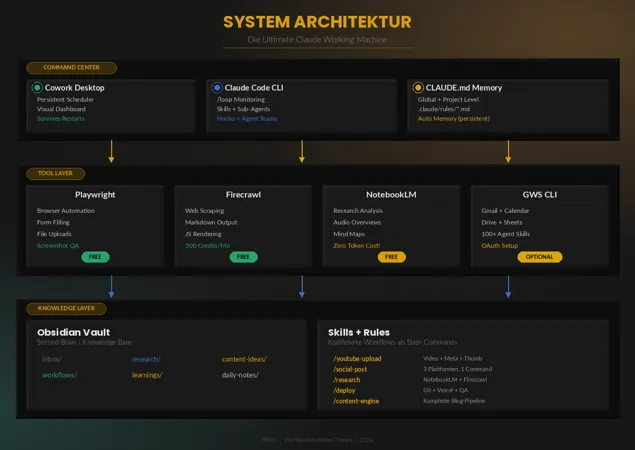
Breite Webrecherche kostet in Claude Code und Codex schnell viel Kontext, obwohl Gemini Notebook Deep Research bereits im kostenlosen Standardzugang mitbringt. notebooklm-py verbindet beide Seiten: Der Agent stößt die Recherche dort an und verarbeitet anschließend nur den geprüften Quellenkern weiter; dieser Artikel zeigt, was davon heute wirklich funktioniert und wo die Grenzen liegen.
Du sagst Claude Code oder Codex, welchen Artikel du brauchst. Über notebooklm-py startet der Agent Deep Research in Gemini Notebook und verlagert die breite Recherche in dessen kostenlosen Standardzugang, statt jedes Rohdokument im bezahlten Agentenkontext zu verarbeiten.
NotebookLM heißt seit dem 16. Juli 2026 offiziell Gemini Notebook. Das Open-Source-Projekt notebooklm-py behält seinen bisherigen Paketnamen; deshalb tauchen hier beide Begriffe auf.
Gemini Notebook sammelt Quellen und bereitet Outline sowie Abschnittsbriefings vor. Claude Code oder Codex schreibt daraus den Artikel. Der geprüfte Text kann anschließend wieder die Grundlage für Audio, Video, Infografiken und Slides in Gemini Notebook werden.
Praktisch getestet ist bisher der Recherche-Pilot. Outline, Abschnittsbriefings und der komplette Medien-Loop sind die technisch gestützte Ausbaustufe und werden hier nicht als bereits fertiger Autopilot verkauft.
notebooklm-pyverbindet den Schreibagenten mit NotebookLM über eine inoffizielle CLI-, Python- und Agent-Skill-Schicht.- NotebookLM übernimmt eine breite Deep-Research-Suche und liefert einen kontrollierten Quellenkern. Codex oder Claude Code schreibt und prüft den finalen Artikel.
- Der reale Pilot fand 62 Kandidaten und wählte 50 zitierte Kandidaten aus. Er hat zugleich eine schlechte erste Quellentriage sichtbar gemacht.
- Der finale Artikel kann der gemeinsame Medien-Master für Audio, Video, eine Infografik und Slides werden. Dieser vollständige Medien-Loop wurde hier noch nicht durchlaufen.
- Der NotebookLM-Standardzugang kann breite Recherche aus dem bezahlten Agent-Kontext heraushalten. Er macht Codex oder Claude Code nicht gratis, und eine prozentuale Ersparnis ist nicht gemessen.
Der eigentliche Hack ist die Brücke
NotebookLM allein ist ein Recherche-Arbeitsraum. Du legst ein Notebook an, fügst Quellen hinzu, stellst Fragen und startest anschließend Medienaufgaben selbst. Das ist nützlich, aber der Wechsel zwischen Recherche, Briefing und Schreibagent bleibt an dir hängen.
Mit notebooklm-py kann der Agent diese klar abgegrenzten Schritte anstoßen: ein Notebook anlegen, Quellen hinzufügen, strukturierte Fragen stellen und später eine Medienaufgabe vorbereiten. Er bekommt dadurch keine Zaubermacht und veröffentlicht nichts selbst. Aber die Recherche wird Teil eines zusammenhängenden Workflows statt eines zweiten Arbeitsplatzes.
Der Ablauf passt als Recherche-Ebene in meinen allgemeinen Content-Pipeline-Aufbau. Hier geht es bewusst um diese Verbindung, nicht um eine allgemeine NotebookLM-Featureliste.
Ist notebooklm-py eine NotebookLM API?
Kurz: technisch ja, offiziell nein. notebooklm-py bietet eine inoffizielle Python-API, eine CLI und einen Agent Skill. Es ist nicht die offizielle Google-API für NotebookLM.
Das Projekt steht unter der MIT-Lizenz. Für diesen Workflow ist die Repository-Version, konkret Release v0.8.1, die relevante Grundlage. Wer jeden Schalter nachschlagen will, findet ihn in der fest gepinnten CLI-Referenz für v0.8.1.
Der Beweis im Artikel bleibt bewusst klein:
$researchStart = notebooklm source add-research --prompt-file research-query.md --mode deep --no-wait -n $notebookId --json | ConvertFrom-Json
$runId = if ($researchStart.poll_task_id) { $researchStart.poll_task_id } else { $researchStart.task_id }
notebooklm research wait --timeout 1800 -n $notebookId --json
notebooklm research import --run-id $runId --cited-only --max-sources 20 -n $notebookId --json
notebooklm ask --prompt-file outline.md -n $notebookId --json
Die erste Zeile startet Deep Research mit einer gespeicherten Recherchefrage und wartet nicht auf den ganzen Lauf. Die JSON-Antwort enthält task_id und optional poll_task_id, nicht $runId. $runId ist eine lokale Variable: Sie nimmt poll_task_id, wenn es vorhanden ist, sonst task_id. Die dritte Zeile wartet, bis der Status den Lauf als abgeschlossen bestätigt. Erst danach importiert die vierte Zeile die zitierten Quellen. Die fünfte stellt dem Notebook eine Outline-Frage aus einer Datei und gibt das Ergebnis maschinenlesbar zurück.
Das ist absichtlich kein Installations-Tutorial. Der entscheidende Punkt ist die Rolle: Über notebooklm-py erhalten Claude Code oder Codex eine kontrollierbare Recherche-Verbindung zu NotebookLM. Sie bleibt von einer nicht offiziellen Google-API abhängig.
Was heute schon getestet ist
Der Research-Pilot begann mit drei Startquellen. Deep Research ergänzte daraus 62 Quellenkandidaten; 50 zitierte Kandidaten wurden für den Import ausgewählt.
Der erste Durchlauf war zugleich der Warnschuss. Die automatische Triage behandelte ihren eigenen Research-Report zu stark wie eine Primärquelle und bevorzugte damit Material, das für den späteren Artikel nicht stabil genug war. Auch ein erfolgreicher Import ist also kein Beweis für eine gute Quellenauswahl.
Beim Research-/Import-Reporting standen 40 importierte Quellen. Der unabhängige Readback der Quellenliste zeigte dagegen 52 Quellen. --max-sources hat in diesem Lauf keine harte Obergrenze bewiesen. Genau deshalb gehört eine Quellenlisten-Prüfung in den festen Ablauf.
Das Ergebnis ist ein fester Prüfschritt: Quellen werden ausgewählt, ihre Originalstellen geprüft und erst dann als Belegkern an den Schreibagenten gegeben. Getestet wurde die Recherche und diese Auswahlgrenze. Audio, Video, Infografik oder Slides wurden in diesem Pilot nicht als fertige Artikelmedien produziert.
So soll der komplette Workflow funktionieren
Das ist die geplante Zielarchitektur für einen wiederholbaren, quellennahen Ablauf. Sie trennt, was bereits getestet ist, von der Ausbaustufe.
1. Der Auftrag startet im Content-Skill
Der Content-Skill hält Leserfrage, Zielgruppe und Anspruch fest. So startet der Agent nicht mit „Schreib mal etwas über NotebookLM“, sondern mit einer konkreten Frage, die der fertige Artikel beantworten soll.
2. notebooklm-py startet Deep Research
Der Agent legt bei Bedarf ein Notebook an, gibt gute Startquellen mit und startet Deep Research. Dadurch beginnt die Suche nicht bei einem zufälligen Suchtreffer.
3. Aus Kandidaten wird ein geprüfter Quellenkern
Kandidaten sind noch keine Belege. Der Agent begrenzt die Auswahl, prüft Originalquellen und dokumentiert Widersprüche oder offene Punkte, bevor der Artikel darauf aufbaut.
4. NotebookLM baut Outline und Abschnittsbriefings
Outline und Abschnittsbriefings entstehen als normale ask --prompt-file-Aufrufe. Sie sind keine besonderen NotebookLM-Artefakte. Sie geben dem Schreibagenten eine Struktur, ersetzen aber nicht die Quellenprüfung.
5. Codex oder Claude Code schreibt den Artikel
Codex oder Claude Code schreibt den Text lokal aus dem geprüften Kern, den Briefings und dem Projektkontext. NotebookLM schreibt nicht direkt in die öffentliche Website.
6. Der fertige Text wird zum Medien-Master
Nach der redaktionellen Prüfung kann der finale Artikel als gemeinsamer Medien-Master dienen. Dafür lädt die Zielarchitektur den finalen Markdown-Artikel als eigene NotebookLM-Quelle hoch:
$finalSource = notebooklm source add final-article.md --type file -n $notebookId --json | ConvertFrom-Json
$finalArticleSourceId = $finalSource.source.id
notebooklm source wait $finalArticleSourceId -n $notebookId --json
source.id kommt aus der JSON-Antwort. $finalArticleSourceId ist der lokal vergebene Name dafür. Erst nach source wait beziehen sich spätere Formate auf dieselben bestätigten Aussagen statt auf eine lose Stichwortliste.
7. Audio, Video, Infografik und Slides entstehen danach
Audio, Video, Infografik und Slides sind danach mögliche Ableitungen. In der Zielarchitektur erhalten sie ausschließlich -s $finalArticleSourceId, also genau den finalen Artikel als Quelle. Das ist geplant und noch nicht als vollständiger End-to-End-Medien-Loop getestet. Sie bleiben Entwürfe, bis Inhalt, sichtbarer Text, Quellenbezug und die vollständige Ausgabe geprüft wurden.
Warum das günstiger sein kann – und was wirklich kostenlos ist
Der mögliche Kostenvorteil kommt nicht aus einer magischen Rechnung. Vollständiges Rohmaterial kann in NotebookLM recherchiert und sortiert werden, statt den gesamten Bestand in den Kontext des Schreibagenten zu laden.
Codex oder Claude Code wird dadurch nicht kostenlos. Für Planung, Belegprüfung, Prosa und Projektintegration braucht der Agent den kuratierten Quellenkern und bezahlten Kontext. NotebookLM-Standardzugang und ein kostenpflichtiges Agent-Abo sind zwei getrennte Dinge.
Der Standardzugang kann die breite Recherche zugänglich machen. Das sagt nichts über garantierte Limits, Dauer oder eine konkrete Ersparnis aus. Eine solche Wirkung müsste über mehrere reale Artikel gemessen werden.
Wo der Workflow bewusst stoppt
Die Verbindung kann ausfallen, wenn eine lokale Sitzung abläuft oder sich die inoffiziellen Endpunkte ändern. Quoten und Rate Limits können einen Lauf ebenfalls bremsen oder abbrechen. Ein technisch erfolgreicher Befehl macht daraus kein inhaltlich vollständiges Ergebnis.
Darum endet der Workflow vor automatischer Veröffentlichung. Originalquellen werden geprüft, unklare Aussagen bleiben draußen, und erzeugte Medien werden vollständig angesehen oder angehört. Erst danach kann jemand entscheiden, ob ein Artikel, Audio, Video, eine Infografik oder Slides wirklich veröffentlicht werden sollen.
Für wen sich die Kombination lohnt
Die Kombination passt zu Solo-Creatorn, die Codex oder Claude Code schon einsetzen und wiederholbare Recherche mit klaren Quellen brauchen. Sie passt weniger, wenn du nur schnell eine einzelne Antwort suchst oder jede Quelle ohnehin selbst im Browser lesen willst.
Wenn du den Agenten-Teil davor einordnen willst, lies mein Claude-Code-Setup. Die Installation erkläre ich hier absichtlich nicht noch einmal.
Fazit: NotebookLM macht die Fleißarbeit, Codex den Artikel
Der Produktivitätsgewinn entsteht nicht durch eine besonders lange Liste an NotebookLM-Funktionen. Er entsteht durch die Brücke: notebooklm-py lässt den Schreibagenten Recherche geordnet anstoßen, ohne die Verantwortung für Auswahl, Prüfung und Veröffentlichung abzugeben.
Genau diese Trennung macht den Ablauf brauchbar. NotebookLM hält die breite Recherche zusammen. Codex oder Claude Code formt daraus einen überprüften Artikel. Alles Weitere bleibt eine bewusst geprüfte Ausbaustufe.